Edge AI: Triển Khai AI Trên Thiết Bị Biên
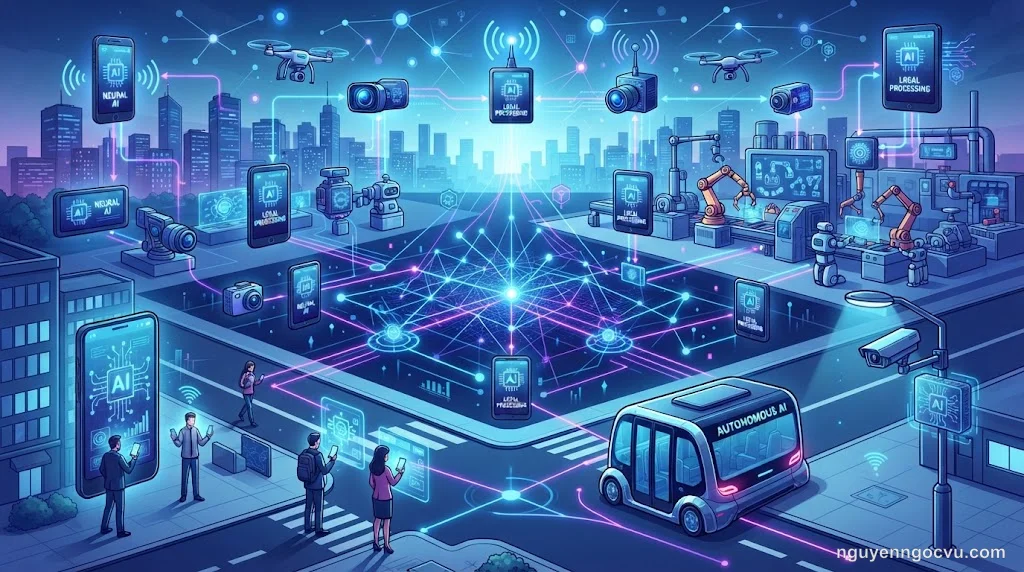
Edge AI đưa trí tuệ nhân tạo từ đám mây xuống tận thiết bị đầu cuối — điện thoại, camera, xe hơi, cảm biến IoT — để xử lý dữ liệu ngay tại chỗ thay vì gửi lên server. Mô hình này giảm độ trễ từ vài trăm mili giây xuống chỉ vài chục, bảo vệ quyền riêng tư vì dữ liệu không rời thiết bị, và hoạt động được cả khi mất kết nối mạng. Đổi lại, bạn phải chấp nhận độ chính xác thấp hơn so với mô hình cloud và tốn công tối ưu để nhét được vào chip nhỏ.
Edge AI là gì và tại sao lại quan trọng?
Edge AI (AI biên) là kiến trúc triển khai trí tuệ nhân tạo trực tiếp trên thiết bị người dùng — không qua trung gian server. Thay vì gửi hình ảnh từ camera an ninh lên đám mây phân tích rồi nhận kết quả trả về, Edge AI cho phép camera tự nhận diện khuôn mặt ngay trong chip của nó.
Điều này quan trọng vì ba lý do:
Độ trễ thấp: Xe tự lái không thể chờ tín hiệu đi đến data center rồi quay lại mới phanh — mỗi mili giây tính bằng mét đường chạy. Edge AI đưa quyết định xuống xe, cắt độ trễ từ 200-500ms (cloud) xuống dưới 50ms.
Quyền riêng tư: Dữ liệu nhạy cảm (khuôn mặt, giọng nói, dữ liệu y tế) xử lý xong rồi bỏ đi ngay trên thiết bị, không bao giờ rời khỏi tay bạn. Đây là yêu cầu pháp lý ở nhiều quốc gia (GDPR, HIPAA).
Hoạt động offline: Thiết bị IoT ở vùng sâu, robot trong nhà máy, điện thoại ở nơi không sóng — Edge AI vẫn chạy bình thường vì mô hình đã nằm sẵn trong chip.
Nhưng không phải miễn phí. Bạn đánh đổi bằng độ chính xác (mô hình nhẹ hơn = ít tham số hơn) và công sức tối ưu hóa (quantization, pruning, model compression) để nhét được vào chip vài trăm MB RAM.
Kiến trúc Edge AI: Từ training đến inference
Pipeline Edge AI chia làm hai giai đoạn rõ rệt:
1. Training trên cloud (vẫn cần server mạnh)
Bạn vẫn huấn luyện mô hình trên GPU cluster hoặc cloud (AWS, GCP, Azure) với dữ liệu đầy đủ. Giai đoạn này không thay đổi — vẫn cần PyTorch/TensorFlow, GPU V100/A100, hàng giờ training.
Sau khi có mô hình chính xác cao (ví dụ 95% accuracy trên ImageNet), bạn bắt đầu nén.
2. Model compression: Từ GB xuống MB
Để chạy được trên thiết bị biên (thường chỉ có 2-4GB RAM, CPU/NPU yếu hơn server hàng chục lần), mô hình cần “giảm cân”:
- Quantization: Chuyển trọng số từ FP32 (4 bytes) sang INT8 (1 byte) — giảm kích thước 4 lần, tăng tốc 2-4 lần, mất độ chính xác khoảng 1-2%.
- Pruning: Loại bỏ các neuron ít đóng góp — cắt 30-50% tham số mà chỉ giảm accuracy <1%.
- Knowledge distillation: Dạy một mô hình nhỏ (student) học theo mô hình lớn (teacher) — MobileNet học từ ResNet, giữ 90% hiệu suất nhưng nhẹ hơn 10 lần.
3. Deploy lên thiết bị với runtime nhẹ
Sau khi nén, bạn chuyển đổi sang định dạng tối ưu cho nền tảng:
- TensorFlow Lite (.tflite): Android, iOS, Raspberry Pi, microcontroller
- Core ML (.mlmodel): iPhone, iPad, Mac
- ONNX Runtime: Đa nền tảng, hỗ trợ cả edge và cloud
- TensorRT: GPU NVIDIA (Jetson Nano, TX2)
Mô hình được tích hợp vào app/firmware, chạy hoàn toàn local. Dữ liệu vào (hình ảnh, âm thanh, cảm biến) → xử lý tại chỗ → kết quả ra ngay lập tức.
Ứng dụng thực tế của Edge AI
Smartphone: Face ID trên iPhone dùng Neural Engine (NPU chuyên dụng) để nhận diện khuôn mặt trong <100ms, hoàn toàn offline. Google Pixel chạy speech recognition cục bộ — bạn nói, máy gõ text ngay cả khi ở chế độ máy bay.
Camera an ninh: Nhận diện người/xe/động vật ngay trong camera, chỉ gửi cảnh báo lên server khi phát hiện sự kiện bất thường. Giảm băng thông từ streaming liên tục 24/7 xuống chỉ vài giây clip.
Xe tự lái: Tesla chạy autopilot trên chip FSD (Full Self-Driving) riêng, xử lý dữ liệu từ 8 camera + radar + lidar để quyết định lái trong <50ms. Dữ liệu không rời xe (trừ khi opt-in gửi về Tesla để cải thiện mô hình).
Y tế đeo tay: Đồng hồ Apple Watch phát hiện rung tâm nhĩ (AFib) bằng ECG cục bộ, cảnh báo ngay mà không cần gửi dữ liệu tim mạch lên cloud.
Robot công nghiệp: Tay robot phân loại sản phẩm lỗi trên băng chuyền dùng vision AI chạy trên NVIDIA Jetson — quyết định loại bỏ trong <10ms mà không chờ server.
Điểm chung: Tất cả đều yêu cầu độ trễ thấp + quyền riêng tư + hoạt động offline — ba thứ mà cloud AI không đáp ứng được.
Thách thức khi triển khai Edge AI
Tài nguyên hạn chế: Thiết bị biên thường có CPU yếu, RAM <4GB, không GPU mạnh. Mô hình phải đủ nhẹ (dưới 100MB) và chạy được với <500 MFLOPS — nghĩa là bạn không thể dùng GPT-4 hay Stable Diffusion trên smartphone.
Quản lý phiên bản mô hình: Khi bạn có 10,000 camera Edge AI, làm sao cập nhật mô hình mới mà không phải đến từng thiết bị? Cần hệ thống OTA (Over-The-Air update) tự động, kiểm tra tương thích phần cứng, rollback khi lỗi.
Đánh đổi accuracy vs latency: Mô hình nhẹ chạy nhanh nhưng kém chính xác. MobileNetV3 chạy 20ms nhưng top-1 accuracy 75%, trong khi ResNet-50 đạt 80% nhưng mất 200ms. Bạn phải chọn điểm cân bằng phù hợp với use case — camera an ninh chấp nhận nhầm 5% để phản ứng nhanh, chẩn đoán y tế thì ngược lại.
Debugging khó khăn: Lỗi trên thiết bị thực khó tái hiện hơn trên server. Bạn cần logging cục bộ, remote monitoring, và test kỹ trên đủ loại phần cứng (chip Qualcomm, MediaTek, Apple Silicon đều có quirk riêng).
Bảo mật mô hình: Mô hình nằm trên thiết bị người dùng → có thể bị reverse engineering, trích xuất. Cần mã hóa mô hình (model encryption), obfuscation, hoặc chạy trong Trusted Execution Environment (TEE).
Cách bắt đầu với Edge AI (bước đi thực tế)
Bước 1: Chọn use case phù hợp
Không phải mọi bài toán AI đều cần Edge. Hỏi:
- Độ trễ <100ms có quan trọng không? (xe tự lái: có, chatbot: không)
- Dữ liệu có nhạy cảm không? (y tế: có, dự báo thời tiết: không)
- Thiết bị có kết nối ổn định không? (nhà máy: có thể mất sóng → cần Edge)
Nếu cả ba câu trả lời “có” hoặc hai trong ba, Edge AI phù hợp.
Bước 2: Huấn luyện mô hình baseline
Dùng framework quen thuộc (PyTorch, TensorFlow) train mô hình tốt nhất có thể trên cloud. Đừng lo về kích thước lúc này — chỉ cần accuracy cao.
Bước 3: Nén mô hình
Áp dụng quantization (TensorFlow Lite converter hỗ trợ sẵn post-training quantization), pruning (PyTorch có torch.nn.utils.prune), hoặc train lại với kiến trúc nhẹ (MobileNet, EfficientNet, YOLO-Nano).
Benchmark trên thiết bị thật: đo inference time, RAM usage, accuracy. Điều chỉnh mức nén cho đến khi đạt tradeoff chấp nhận được.
Bước 4: Deploy với runtime tối ưu
- Android/iOS: Tích hợp TensorFlow Lite hoặc Core ML vào app, gọi inference từ Java/Kotlin/Swift.
- Embedded (Raspberry Pi, Jetson): Chạy ONNX Runtime hoặc TensorRT, viết service Python gọi mô hình khi có dữ liệu sensor.
- Microcontroller (Arduino, ESP32): Dùng TensorFlow Lite Micro (mô hình <50KB, chạy được trên 256KB RAM).
Bước 5: Theo dõi và cập nhật
Edge AI không “fire and forget”.
Theo dõi ba thứ:
- Model drift: Accuracy giảm dần theo thời gian khi dữ liệu thực tế thay đổi.
- Hardware issues: Một số chip có bug driver, gây kết quả sai.
- User feedback: Thu thập mẫu dữ liệu thất bại (với sự đồng ý người dùng) để retrain.
Thiết lập pipeline CI/CD cho Edge: auto-test trên thiết bị mô phỏng → beta test trên một phần thiết bị → rollout toàn bộ nếu metrics ổn định.
Tương lai của Edge AI: Từ smartphone đến mọi vật
Edge AI đang mở rộng từ smartphone/camera sang mọi thiết bị IoT. Chip AI chuyên dụng (NPU, TPU) ngày càng rẻ và mạnh — Google Coral Edge TPU giá $60 chạy được MobileNet 400 FPS, Apple M-series tích hợp Neural Engine 15 TOPS vào laptop.
Xu hướng đáng chú ý:
Federated Learning: Huấn luyện mô hình phân tán — mỗi thiết bị train trên dữ liệu cục bộ, chỉ gửi gradient về server tổng hợp. Gboard của Google dùng kỹ thuật này để cải thiện autocorrect mà không thu thập dữ liệu gõ của bạn.
TinyML: AI trên microcontroller — nhận diện giọng nói, phát hiện cử chỉ, phân loại âm thanh chạy trên chip <1 đô la, tiêu thụ <1mW. Keyword spotting (“OK Google”) chạy hoàn toàn trên chip riêng, chỉ đánh thức CPU khi nghe thấy từ khóa.
Hybrid Edge-Cloud: Mô hình nhẹ chạy trên edge để phản ứng nhanh, mô hình nặng chạy trên cloud khi cần độ chính xác cao. Camera nhận diện người qua lại bằng Edge, chỉ gửi khuôn mặt lạ lên cloud để tra cứu database — kết hợp ưu điểm của cả hai.
Đọc thêm:
- MLOps: Vận Hành Mô Hình Machine Learning Trong Production — Hệ thống quản lý lifecycle mô hình AI từ training đến deploy, bao gồm cả Edge deployment và monitoring.
- AI Model Compression: Quantization và Pruning — Kỹ thuật nén mô hình AI chi tiết để triển khai lên thiết bị edge với tài nguyên hạn chế.
Câu hỏi thường gặp
Edge AI khác gì với Cloud AI?
Edge AI chạy mô hình trực tiếp trên thiết bị đầu cuối (điện thoại, camera, cảm biến), trong khi Cloud AI gửi dữ liệu lên server xử lý. Edge giảm độ trễ và bảo mật hơn nhưng hạn chế về tài nguyên.
Thiết bị nào có thể chạy Edge AI?
Smartphone, camera an ninh, xe tự lái, thiết bị y tế đeo tay, drone, robot công nghiệp — bất kỳ thiết bị nào có chip xử lý đủ mạnh (CPU, GPU, NPU hoặc TPU chuyên dụng).
Framework nào phổ biến cho Edge AI?
TensorFlow Lite (di động, IoT), ONNX Runtime (đa nền tảng), Core ML (iOS), PyTorch Mobile, OpenVINO (Intel), TensorRT (NVIDIA) — tùy thuộc vào nền tảng và yêu cầu hiệu năng.
Edge AI có cần kết nối mạng không?
Không bắt buộc khi suy luận. Mô hình đã huấn luyện chạy hoàn toàn offline trên thiết bị. Kết nối chỉ cần khi cập nhật mô hình hoặc đồng bộ dữ liệu.


