Federated Learning: Học Máy Liên Kết Bảo Mật Dữ Liệu
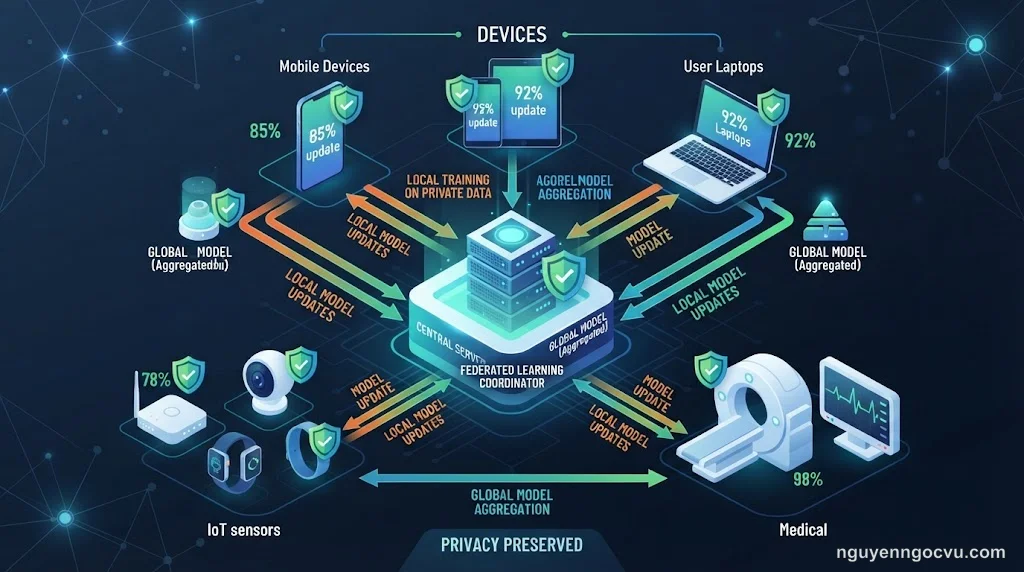
Federated Learning (học máy liên kết) là phương pháp huấn luyện mô hình AI trên dữ liệu phân tán từ hàng triệu thiết bị mà không cần thu thập dữ liệu về một máy chủ tập trung. Thay vì chuyển dữ liệu thô, mỗi thiết bị huấn luyện mô hình cục bộ và chỉ gửi bản cập nhật trọng số về máy chủ để tổng hợp, bảo vệ quyền riêng tư người dùng và tuân thủ GDPR, CCPA. Công nghệ này đã được Google, Apple triển khai thực tế trên hàng tỷ điện thoại.
Federated Learning là gì và tại sao cần thiết?
Federated Learning (FL) ra đời từ nghiên cứu của Google năm 2016, giải quyết bài toán: làm sao huấn luyện AI trên dữ liệu cá nhân (tin nhắn, ảnh, lịch sử tìm kiếm) mà không vi phạm quyền riêng tư?
Machine Learning truyền thống hoạt động theo luồng thu thập tập trung: gom hết dữ liệu từ hàng triệu người dùng về một data center, lưu trữ, rồi huấn luyện. Nghe quen? Đúng vậy, đây là mô hình khiến Cambridge Analytica và Yahoo breach từng xảy ra.
Ba vấn đề chết người:
- Vi phạm quyền riêng tư: Người dùng mất kiểm soát hoàn toàn dữ liệu cá nhân khi nó rời khỏi thiết bị.
- Rủi ro rò rỉ: Một lần vi phạm bảo mật tại máy chủ trung tâm là toàn bộ dữ liệu bị lộ.
- Không tuân thủ pháp luật: GDPR (châu Âu) và CCPA (California) hạn chế chuyển dữ liệu cá nhân ra ngoài vùng — doanh nghiệp toàn cầu đau đầu vì thế.
Federated Learning đảo ngược luồng: đưa mô hình đến dữ liệu, không đưa dữ liệu về mô hình.
Quy trình như thế nào? Năm bước:
- Máy chủ gửi mô hình ban đầu xuống hàng nghìn thiết bị (điện thoại, laptop, thiết bị y tế).
- Mỗi thiết bị huấn luyện mô hình trên dữ liệu cục bộ riêng — ví dụ 500 ảnh trong thư viện cá nhân.
- Thiết bị gửi lại chỉ bản cập nhật trọng số mô hình (gradients). Ảnh gốc? Không bao giờ rời khỏi thiết bị.
- Máy chủ tổng hợp các bản cập nhật từ nhiều thiết bị thành một mô hình toàn cục cải tiến.
- Lặp lại cho đến khi mô hình hội tụ.
Lợi ích thực tế: Google sử dụng FL để cải thiện Gboard (bàn phím Android) — học cách người dùng gõ từ mới, biểu tượng cảm xúc — mà không bao giờ thấy nội dung tin nhắn thật. Apple dùng FL cho Siri, Hey Siri personalization, và QuickType suggestions.
Federated Learning hoạt động như thế nào?
Kiến trúc FL gồm ba thành phần chính:
1. Thiết bị đầu cuối (Edge Devices)
Mỗi thiết bị (điện thoại, máy tính, xe tự lái, thiết bị IoT) là một node huấn luyện cục bộ. Thiết bị:
- Tải mô hình toàn cục hiện tại từ máy chủ.
- Huấn luyện mô hình trên tập dữ liệu riêng (ví dụ: 500 ảnh trong thư viện cá nhân).
- Tính toán gradient (hướng cập nhật trọng số) từ quá trình huấn luyện.
- Gửi gradient về máy chủ (thường chỉ vài MB thay vì GB dữ liệu thô).
Thách thức: Dữ liệu trên mỗi thiết bị không giống nhau (non-IID: non-independent and identically distributed). Ví dụ: người dùng A chụp toàn ảnh mèo, người dùng B toàn ảnh phong cảnh. Mô hình phải học được từ phân bố dữ liệu không cân bằng này.
2. Máy chủ tổng hợp (Aggregation Server)
Máy chủ không lưu trữ dữ liệu gốc, chỉ nhận gradient từ hàng nghìn thiết bị và thực hiện aggregation (tổng hợp). Thuật toán phổ biến nhất:
Federated Averaging (FedAvg): Trung bình trọng số các mô hình cục bộ theo số lượng mẫu dữ liệu mỗi thiết bị đóng góp.
w_global(t+1) = Σ (n_k / N) × w_k(t)
Trong đó:
w_global: trọng số mô hình toàn cụcw_k: trọng số từ thiết bị thứ kn_k: số mẫu dữ liệu trên thiết bị kN: tổng số mẫu từ tất cả thiết bị
Máy chủ sau đó phát mô hình cập nhật trở lại các thiết bị để bắt đầu vòng tiếp theo.
Thách thức: Băng thông mạng hạn chế. Nếu mỗi thiết bị gửi mô hình 100MB lên máy chủ hàng triệu lần, chi phí truyền tải khổng lồ. Giải pháp: gradient compression (nén gradient bằng quantization, sparsification).
3. Kỹ thuật bảo mật bổ sung
FL đã bảo vệ quyền riêng tư hơn ML truyền thống, nhưng gradient vẫn có thể bị khai thác. Hai kỹ thuật thường kết hợp:
Differential Privacy (DP): Thêm nhiễu ngẫu nhiên vào gradient trước khi gửi, khiến không thể khôi phục lại dữ liệu gốc từ gradient. Trade-off: nhiễu quá nhiều làm giảm độ chính xác mô hình.
Secure Aggregation: Mã hóa gradient của mỗi thiết bị bằng cryptography, máy chủ chỉ có thể giải mã tổng tất cả gradient mà không thấy gradient riêng lẻ từng thiết bị. Ngăn chặn máy chủ độc hại theo dõi từng người dùng.
Ứng dụng thực tế của Federated Learning
Y tế: Huấn luyện AI trên dữ liệu bệnh nhân mà không chia sẻ hồ sơ
Bệnh viện A có 10.000 ảnh X-quang phổi, bệnh viện B có 8.000 ảnh, bệnh viện C có 12.000. Dữ liệu này nhạy cảm, không thể gộp chung do luật HIPAA (Mỹ) hoặc GDPR (châu Âu).
FL cho phép ba bệnh viện cùng huấn luyện một mô hình chẩn đoán ung thư phổi mà không cần chuyển ảnh X-quang ra ngoài. Mỗi bệnh viện huấn luyện mô hình trên dữ liệu nội bộ, gửi cập nhật trọng số về một máy chủ trung gian (có thể là trường đại học, tổ chức nghiên cứu), máy chủ tổng hợp thành mô hình toàn cục chính xác hơn mô hình của từng bệnh viện đơn lẻ.
Kết quả thực tế: Đại học Stanford và NVIDIA đã triển khai FL cho 20 bệnh viện trên thế giới, huấn luyện mô hình phân đoạn khối u não (brain tumor segmentation) đạt độ chính xác 92%, tương đương mô hình huấn luyện tập trung nhưng hoàn toàn không chia sẻ dữ liệu bệnh nhân.
Tài chính: Phát hiện gian lận từ dữ liệu giao dịch phân tán
Ngân hàng muốn huấn luyện mô hình phát hiện giao dịch gian lận, nhưng không thể gộp dữ liệu giao dịch khách hàng từ nhiều chi nhánh về một data center (rủi ro rò rỉ cao, vi phạm quy định bảo mật tài chính).
FL cho phép mỗi chi nhánh huấn luyện mô hình trên lịch sử giao dịch cục bộ, gửi gradient về trung tâm, tổng hợp thành mô hình toàn cầu nhận diện pattern gian lận trên toàn hệ thống mà không cần thấy chi tiết giao dịch từng khách hàng.
WeBank (Trung Quốc) đã triển khai nền tảng FL có tên FATE (Federated AI Technology Enabler) phục vụ 300 triệu người dùng, giảm gian lận thẻ tín dụng 23% mà không vi phạm luật bảo mật dữ liệu.
Điện thoại di động: Cải thiện AI mà không thu thập dữ liệu người dùng
Google Gboard (bàn phím Android) sử dụng FL để học từ vựng mới, emoji thường dùng, cách người dùng sửa lỗi chính tả — tất cả trên thiết bị cá nhân. Dữ liệu gõ phím không bao giờ rời khỏi điện thoại.
Apple triển khai FL cho:
- Hey Siri personalization: Học giọng nói của chủ sở hữu để chỉ đáp ứng giọng đó, không đáp ứng người khác.
- QuickType suggestions: Gợi ý từ tiếp theo khi gõ tin nhắn dựa trên thói quen cá nhân.
- Health app insights: Phân tích xu hướng sức khỏe từ dữ liệu Apple Watch mà không gửi nhịp tim, bước chân lên iCloud.
Cả Google và Apple báo cáo rằng chất lượng mô hình FL tương đương hoặc tốt hơn mô hình huấn luyện tập trung trên cùng tác vụ.
IoT và xe tự lái: Học từ môi trường thực mà không truyền video/sensor thô
Xe Tesla thu thập petabyte dữ liệu camera, radar, lidar mỗi ngày từ hàng triệu xe trên đường. Truyền tất cả về data center là không khả thi (chi phí băng thông khổng lồ, độ trễ cao).
FL cho phép mỗi xe huấn luyện mô hình nhận diện đối tượng (người đi bộ, biển báo, xe khác) trên dữ liệu ghi được trong ngày, chỉ gửi cập nhật mô hình (vài MB) về máy chủ vào cuối ngày khi xe đỗ và kết nối WiFi. Mô hình toàn cục học được từ vô số tình huống lái xe thực tế trên khắp thế giới mà không cần lưu trữ video thô.
So sánh Federated Learning với các phương pháp khác
| Tiêu chí | Machine Learning truyền thống | Federated Learning | Split Learning | Differential Privacy đơn thuần |
|---|---|---|---|---|
| Dữ liệu di chuyển | Toàn bộ về máy chủ | Không, chỉ gradient | Một phần (activations) | Toàn bộ về máy chủ + nhiễu |
| Quyền riêng tư | Thấp | Cao | Cao | Trung bình |
| Độ chính xác mô hình | Cao nhất (có toàn bộ dữ liệu) | Gần tương đương | Gần tương đương | Giảm (do nhiễu) |
| Chi phí băng thông | Rất cao | Thấp–Trung bình | Thấp | Rất cao |
| Độ phức tạp triển khai | Thấp | Cao | Cao | Thấp |
| Khả năng mở rộng | Tốt (data center mạnh) | Tốt (phân tán) | Vừa (cần phối hợp chặt) | Tốt |
| Use case tiêu biểu | Mọi ML task truyền thống | IoT, mobile, y tế, tài chính | Edge AI với tài nguyên hạn chế | Báo cáo thống kê dân số, khảo sát |
Khi nào dùng FL? Dữ liệu nhạy cảm. Phân tán trên nhiều thiết bị/tổ chức. Quy định pháp lý nghiêm ngặt. Băng thông hạn chế. Bất kỳ tình huống nào trong số này đều là lý do đủ.
Khi nào KHÔNG dùng FL? Dữ liệu đã tập trung sẵn thì đừng phức tạp hóa. Không có yêu cầu quyền riêng tư cao thì dùng ML truyền thống cho đơn giản. Cần debug chi tiết từng mẫu? FL sẽ làm bạn khổ sở. Đội ngũ chưa có kinh nghiệm xử lý hệ thống phân tán phức tạp? Đừng bắt đầu ở đây.
Công cụ và framework Federated Learning phổ biến
TensorFlow Federated (TFF)
Framework mã nguồn mở từ Google, tích hợp sâu với TensorFlow. Hỗ trợ mô phỏng FL trên một máy (để phát triển) và triển khai thật trên thiết bị Android/iOS.
Ưu điểm: Tài liệu đầy đủ, cộng đồng lớn, tích hợp TensorFlow Extended (TFX) cho production pipeline.
Nhược điểm: Chỉ hỗ trợ TensorFlow, đường cong học tập dốc với người mới.
import tensorflow_federated as tff

# Định nghĩa mô hình Keras
def create_keras_model():
    return tf.keras.Sequential([
        tf.keras.layers.Dense(128, activation='relu', input_shape=(784,)),
        tf.keras.layers.Dense(10, activation='softmax')
    ])

# Tạo FL process
model_fn = tff.learning.from_keras_model(...)
federated_averaging = tff.learning.build_federated_averaging_process(model_fn)

# Chạy vòng FL
state = federated_averaging.initialize()
for round in range(100):
    state, metrics = federated_averaging.next(state, federated_data)
    print(f'Round {round}, loss={metrics.loss}')
PySyft (OpenMined)
Framework nghiên cứu mã nguồn mở, hỗ trợ FL, differential privacy, encrypted computation. Tích hợp PyTorch.
Ưu điểm: Tập trung vào privacy-preserving AI, dễ thử nghiệm ý tưởng mới, cộng đồng nghiên cứu sôi động.
Nhược điểm: Chưa sẵn sàng production ở quy mô lớn, API thay đổi nhanh giữa các phiên bản.
Flower (Adap)
Framework FL nhẹ, hỗ trợ nhiều ML framework (PyTorch, TensorFlow, scikit-learn, Hugging Face). Thiết kế đơn giản, dễ tích hợp vào hệ thống có sẵn.
Ưu điểm: Linh hoạt nhất, code ít, triển khai nhanh.
Nhược điểm: Cộng đồng nhỏ hơn TFF, ít tài liệu case study production.
import flwr as fl

# Định nghĩa FL client
class MyClient(fl.client.NumPyClient):
    def get_parameters(self):
        return model.get_weights()

    def fit(self, parameters, config):
        model.set_weights(parameters)
        model.fit(X_train, y_train, epochs=1)
        return model.get_weights(), len(X_train), {}

# Khởi chạy client
fl.client.start_numpy_client(server_address="localhost:8080", client=MyClient())
FATE (WeBank)
Nền tảng FL cấp doanh nghiệp từ WeBank (Trung Quốc), tập trung vào tài chính và y tế. Bao gồm giao diện web quản lý, federated feature engineering, secure multi-party computation (MPC).
Ưu điểm: Production-ready cho ngân hàng, bảo hiểm, hỗ trợ compliance pháp lý châu Á.
Nhược điểm: Tài liệu chủ yếu tiếng Trung, setup phức tạp, thiên về vertical FL (liên kết dữ liệu giữa các tổ chức).
Thách thức kỹ thuật khi triển khai Federated Learning
1. Dữ liệu không đồng nhất (Non-IID)
Trong ML truyền thống, dữ liệu huấn luyện thường được xáo trộn đồng đều (IID: independent and identically distributed). FL không có điều này: dữ liệu trên thiết bị A khác hoàn toàn thiết bị B.
Ví dụ: huấn luyện mô hình nhận diện chữ viết tay. Người dùng A sống ở Nhật, toàn chữ Kanji; người dùng B sống ở Pháp, toàn chữ Latin. Mô hình toàn cục phải học được cả hai nhưng mỗi thiết bị chỉ thấy một loại.
Giải pháp: Personalization layers (mỗi thiết bị có một vài layer riêng biệt), meta-learning (học cách học nhanh từ dữ liệu mới), federated multi-task learning.
2. Thiết bị không ổn định
Điện thoại có thể tắt nguồn giữa chừng, mất mạng, hoặc người dùng mở app khác. FL phải chịu lỗi khi 30–50% thiết bị dropout giữa vòng huấn luyện.
Giải pháp: Checkpoint thường xuyên, chỉ tổng hợp gradient từ thiết bị hoàn thành vòng huấn luyện, bỏ qua các thiết bị rơi ra giữa chừng.
3. Băng thông và chi phí truyền thông
Mô hình lớn (VGG, ResNet, GPT) có hàng trăm triệu tham số. Gửi toàn bộ gradient lên xuống mỗi vòng tốn nhiều GB dữ liệu.
Giải pháp:
- Gradient compression: Quantization (giảm precision từ float32 xuống int8), sparsification (chỉ gửi top-k gradient lớn nhất).
- Model compression: Pruning (cắt tỉa tham số không quan trọng), knowledge distillation (chuyển sang mô hình nhỏ hơn).
- Asynchronous FL: Không chờ tất cả thiết bị, cập nhật mô hình ngay khi có đủ một số lượng thiết bị trả gradient.
4. Độ tin cậy và tấn công độc hại (Poisoning Attacks)
Một thiết bị độc hại có thể gửi gradient sai để phá hoại mô hình toàn cục (model poisoning) hoặc backdoor attack (chèn lỗ hổng vào mô hình).
Ví dụ: trong mô hình nhận diện hình ảnh, attacker gửi gradient làm mô hình phân loại sai bất kỳ ảnh nào có sticker màu vàng góc dưới phải là “mèo”, kể cả đó là ảnh chó hay xe hơi.
Giải pháp: Byzantine-robust aggregation (loại bỏ gradient outlier trước khi tổng hợp), reputation systems (gán trọng số tin cậy cho mỗi thiết bị dựa trên lịch sử đóng góp).
Xu hướng tương lai của Federated Learning
1. Federated Learning across silos (Vertical FL)
FL hiện tại chủ yếu là horizontal FL: nhiều bên có cùng loại dữ liệu (cùng features khác nhau samples). Ví dụ: nhiều điện thoại cùng có ảnh, tin nhắn.
Vertical FL: các bên có cùng samples nhưng khác features. Ví dụ: ngân hàng có lịch sử giao dịch khách hàng A, công ty viễn thông có lịch sử cuộc gọi của khách hàng A, cùng huấn luyện mô hình credit scoring mà không chia sẻ dữ liệu thô.
Xu hướng: kết hợp FL với secure multi-party computation (MPC), homomorphic encryption để các tổ chức cùng ngành (y tế, tài chính, bán lẻ) hợp tác huấn luyện AI.
2. FL trên 5G và edge computing
5G có băng thông cao, độ trễ thấp (1ms), hỗ trợ hàng triệu thiết bị kết nối đồng thời. FL sẽ mở rộng sang:
- Smart cities (camera giám sát, cảm biến giao thông huấn luyện mô hình dự đoán tắc nghẽn).
- Industrial IoT (nhà máy thông minh, bảo trì dự đoán máy móc).
- AR/VR (huấn luyện mô hình nhận diện cử chỉ, môi trường 3D từ hàng triệu thiết bị đeo).
3. FL kết hợp reinforcement learning
Huấn luyện agent chơi game, robot, xe tự lái bằng federated reinforcement learning: mỗi agent học từ môi trường riêng, chia sẻ policy updates mà không chia sẻ trajectory data.
Ví dụ: hàng nghìn robot kho hàng Amazon học cách di chuyển tối ưu từ kinh nghiệm tại từng kho riêng biệt, tổng hợp thành policy toàn cầu.
4. Tiêu chuẩn hóa và quy định pháp lý
Hiện chưa có tiêu chuẩn quốc tế nào cho FL. IEEE, IETF, và W3C đang làm việc định nghĩa giao thức FL chuẩn (federated learning protocol), format trao đổi mô hình, audit trail để chứng minh tuân thủ GDPR.
EU AI Act (2024) và các luật tương tự sẽ yêu cầu doanh nghiệp chứng minh cách họ bảo vệ dữ liệu huấn luyện AI. FL + differential privacy sẽ trở thành compliance requirement, không chỉ best practice.
Kết luận
Federated Learning đại diện cho sự chuyển dịch từ data-centric AI (tập trung dữ liệu) sang privacy-centric AI (tập trung quyền riêng tư).
Câu hỏi không còn là “làm sao thu thập được nhiều dữ liệu nhất?” mà trở thành “làm sao huấn luyện AI hiệu quả mà không cần sở hữu dữ liệu?”. Đó là sự khác biệt cốt lõi.
Những năm tới? FL sẽ không còn là công nghệ niche cho Google/Apple. Nó sẽ trở thành kiến trúc tiêu chuẩn cho AI trong y tế, tài chính, IoT — bất kỳ lĩnh vực nào dữ liệu nhạy cảm hoặc phân tán tự nhiên. Nắm vững FL ngay hôm nay là đầu tư vào kỹ năng cốt lõi của kỷ nguyên AI bảo mật quyền riêng tư.
Đọc thêm:
- Transfer Learning: Tái Sử Dụng Tri Thức AI Tiết Kiệm 90% Chi Phí — Kỹ thuật bổ sung cho FL khi cần tận dụng mô hình đã huấn luyện sẵn để giảm chi phí, đặc biệt hữu ích khi các thiết bị FL có tài nguyên hạn chế.
- AI Model Compression: Nén Mô Hình AI Hiệu Quả Để Triển Khai Thực Tế — Giải quyết thách thức băng thông và tài nguyên thiết bị trong FL bằng cách giảm kích thước mô hình mà vẫn giữ độ chính xác.
- Edge AI: Triển Khai AI Trên Thiết Bị Đầu Cuối — Kiến trúc đầu cuối mà FL phụ thuộc vào, bao gồm cách tối ưu inference trên điện thoại, IoT và thiết bị nhúng.
Câu hỏi thường gặp
Federated Learning khác gì với Machine Learning truyền thống?
Machine Learning truyền thống yêu cầu thu thập toàn bộ dữ liệu về một máy chủ tập trung để huấn luyện. Federated Learning huấn luyện mô hình trực tiếp trên thiết bị của người dùng (điện thoại, máy tính, IoT), chỉ gửi bản cập nhật mô hình về máy chủ mà không chia sẻ dữ liệu thô.
Federated Learning có thực sự an toàn không?
Federated Learning cải thiện quyền riêng tư vì dữ liệu gốc không rời khỏi thiết bị người dùng. Tuy nhiên, các bản cập nhật mô hình vẫn có thể bị tấn công model inversion hoặc membership inference. Do đó, cần kết hợp thêm differential privacy và secure aggregation để đảm bảo an toàn tối đa.
Những ngành nào đang ứng dụng Federated Learning?
Y tế (huấn luyện mô hình trên dữ liệu bệnh nhân từ nhiều bệnh viện mà không chia sẻ hồ sơ), tài chính (phát hiện gian lận từ dữ liệu giao dịch phân tán), điện thoại di động (cải thiện gợi ý bàn phím, nhận diện giọng nói) và IoT (xe tự lái, thiết bị thông minh gia đình).
Federated Learning có nhược điểm gì?
Thách thức chính bao gồm dữ liệu không đồng nhất (non-IID) giữa các thiết bị, băng thông mạng hạn chế, thiết bị không ổn định (tắt nguồn giữa chừng), và việc debug khó khăn hơn so với huấn luyện tập trung. Cần thiết kế hệ thống chịu lỗi và tối ưu giao thức giao tiếp.


