Edge AI: Triển Khai AI Trên Thiết Bị Đầu Cuối
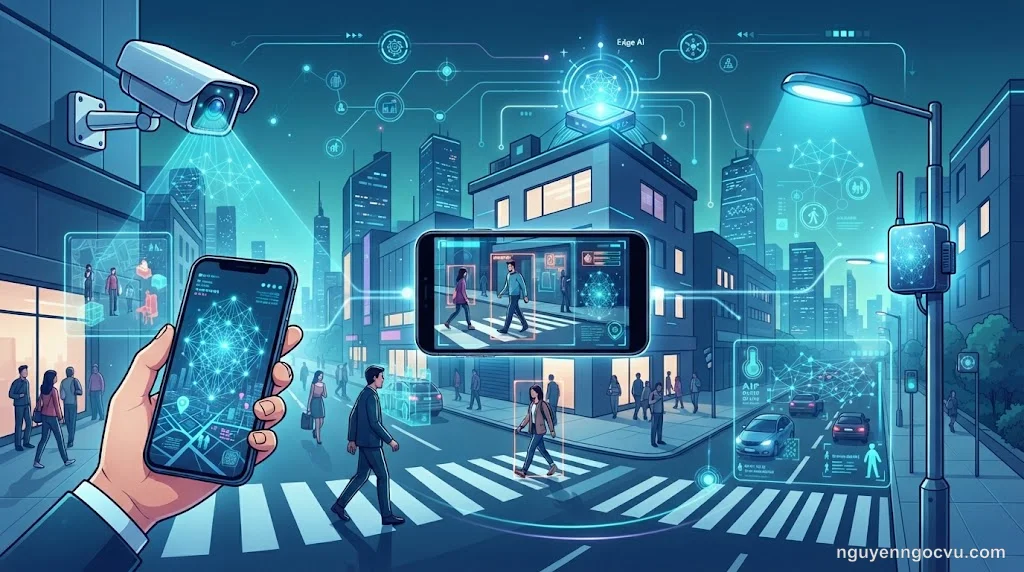
Edge AI chạy trí tuệ nhân tạo ngay trên thiết bị đầu cuối như smartphone, camera, xe tự lái thay vì gửi dữ liệu lên cloud. Lợi ích: phản hồi tức thì (dưới 10ms), bảo mật cao (dữ liệu không rời thiết bị), hoạt động offline, tiết kiệm băng thông. Thách thức: hạn chế tài nguyên (RAM/CPU/pin), cần tối ưu model (quantization, pruning). Phù hợp khi cần real-time (nhận diện khuôn mặt, AR), riêng tư (y tế, camera), hoặc không có mạng.
Edge AI là gì và tại sao quan trọng?
Edge AI (AI biên) là việc chạy các mô hình machine learning trực tiếp trên thiết bị đầu cuối (edge device) thay vì gửi dữ liệu lên server cloud để xử lý. “Edge” ở đây chỉ vị trí gần người dùng nhất: smartphone trong tay bạn, camera an ninh ở cửa, cảm biến trong xe.
Tại sao Edge AI ngày càng phổ biến?
- Độ trễ thấp (low latency): Xử lý tại chỗ → kết quả trong vài milliseconds. VR/AR, xe tự lái, robot công nghiệp cần phản hồi dưới 10ms — cloud không đáp ứng được.
- Bảo mật riêng tư: Dữ liệu nhạy cảm (khuôn mặt, giọng nói, y tế) không rời thiết bị. Camera nhận diện khuôn mặt xử lý ngay trên chip, không upload lên internet.
- Offline: Không phụ thuộc internet. Thiết bị vẫn hoạt động khi mất mạng — quan trọng với IoT nông nghiệp, y tế vùng xa, kho hàng.
- Giảm chi phí băng thông & cloud: Không phải gửi hàng GB video/hình ảnh lên server. Chỉ gửi kết quả đã xử lý (vài KB metadata).
- Quy mô lớn: Hàng triệu thiết bị IoT — nếu đều gửi cloud sẽ quá tải. Edge phân tán tải xử lý.
Trade-off: Edge AI đánh đổi sức mạnh tính toán (thiết bị yếu hơn server) để lấy tốc độ và riêng tư. Model phải nhỏ gọn, tối ưu.
Kiến trúc Edge AI: Từ training đến deployment
Edge AI không thay thế hoàn toàn cloud — mà là mô hình hybrid:
1. Training ở cloud (nơi có GPU mạnh)
Model phức tạp (ResNet, BERT, GPT) được train trên cluster GPU/TPU. Ví dụ: train model nhận diện đối tượng trên ImageNet với hàng triệu ảnh.
2. Tối ưu model cho edge (compression)
Model gốc quá lớn (hàng trăm MB, hàng tỷ phép tính) không chạy được trên smartphone. Cần:
- Quantization: Giảm độ chính xác số từ FP32 (32-bit) xuống INT8 (8-bit) → giảm 75% kích thước, nhanh hơn 2-4 lần, mất <1% độ chính xác.
- Pruning: Cắt bỏ trọng số/neuron không quan trọng → model thưa (sparse), nhỏ hơn 50-90%.
- Knowledge Distillation: Model lớn (teacher) dạy model nhỏ (student) → student đạt 95-98% hiệu suất teacher nhưng chỉ bằng 1/10 kích thước.
- Model Architecture Search: Thiết kế kiến trúc nhỏ gọn từ đầu (MobileNet, EfficientNet, SqueezeNet).
3. Chuyển đổi sang format edge
Chuyển từ TensorFlow/PyTorch sang:
- TensorFlow Lite (.tflite) cho Android/Linux/microcontroller
- Core ML (.mlmodel) cho iOS/macOS
- ONNX Runtime (.onnx) đa nền tảng (Windows/Android/iOS/web)
4. Deploy lên thiết bị
Nhúng model vào app mobile, firmware IoT, hoặc chip chuyên dụng (NPU - Neural Processing Unit). Ví dụ:
- iPhone có Neural Engine (16-core NPU)
- Google Pixel có Tensor chip
- Qualcomm Snapdragon có Hexagon DSP
5. Inference tại edge
App chạy model local: camera chụp → model phát hiện đối tượng → kết quả hiện ngay (< 50ms). Không cần internet.
6. Update model qua cloud (khi cần)
Định kỳ tải model mới từ cloud khi có cải tiến. Hybrid: edge xử lý thường xuyên, cloud xử lý trường hợp phức tạp.
Công nghệ & framework chính
| Framework | Nền tảng | Đặc điểm | Use case |
|---|---|---|---|
| TensorFlow Lite | Android, iOS, Linux, MCU | Nhẹ, quantization mạnh, Google hỗ trợ | App mobile, IoT, Raspberry Pi |
| Core ML | iOS, macOS | Tối ưu Apple Silicon, tích hợp sâu | App iOS/Mac, Apple Watch |
| ONNX Runtime | Đa nền tảng | Open standard, nhiều backend (CPU/GPU/NPU) | Cross-platform, Azure IoT |
| PyTorch Mobile | Android, iOS | API gần với PyTorch, dễ chuyển đổi | Research → production |
| MediaPipe | Web, mobile, desktop | Pipeline ready-made (pose, face, hand) | AR, fitness, gesture control |
| OpenVINO | Intel CPU/GPU/VPU | Tối ưu Intel hardware | PC edge, CCTV, retail |
Hardware chuyên dụng (accelerator):
- Google Coral (Edge TPU): USB stick hoặc dev board, chạy MobileNet 400 FPS
- NVIDIA Jetson (Nano, Xavier): GPU mạnh, dành cho robot, drone, xe tự lái
- Intel Movidius (VPU): Tối ưu computer vision, tiết kiệm điện
- Apple Neural Engine: 15+ TOPS (trillion ops/sec) trên iPhone 15
Quy trình triển khai Edge AI thực tế
Bước 1: Xác định use case & yêu cầu
- Latency cần đạt bao nhiêu? (real-time < 30ms, interactive < 100ms)
- Thiết bị mục tiêu? (smartphone flagship / phổ thông / MCU)
- Offline hay hybrid?
- Độ chính xác tối thiểu?
Bước 2: Chọn/train model baseline
Train trên cloud hoặc dùng pre-trained model (MobileNetV3, EfficientNet-Lite, YOLOv8n).
Bước 3: Benchmark & tối ưu
- Đo FPS, latency, RAM, battery drain trên thiết bị thật
- Áp dụng quantization → đo lại
- Nếu chưa đạt → pruning / distillation / kiến trúc nhỏ hơn
- Lặp lại cho đến khi đạt yêu cầu
Bước 4: Chuyển đổi model
# TensorFlow → TFLite (INT8 quantization)
tflite_convert --saved_model_dir=model/ --output_file=model.tflite \
  --optimization=DEFAULT --representative_dataset=rep_data.py

# PyTorch → ONNX → TFLite/Core ML
python export_onnx.py model.pth model.onnx
onnx-tf convert -i model.onnx -o model_tf
Bước 5: Tích hợp vào app/thiết bị
// Android TFLite
val interpreter = Interpreter(loadModelFile())
val input = preprocess(bitmap)
interpreter.run(input, output)
val result = postprocess(output)
// iOS Core ML
let model = try VNCoreMLModel(for: MyModel().model)
let request = VNCoreMLRequest(model: model) { request, error in
    guard let results = request.results as? [VNClassificationObservation] else { return }
    print(results.first?.identifier)
}
Bước 6: Test trên thiết bị thật
Đo performance production: FPS, latency, battery, RAM. Kiểm tra edge case (ánh sáng yếu, góc nghiêng, motion blur).
Bước 7: Deploy & monitor
Over-the-air update model qua CI/CD. Theo dõi crash rate, accuracy drift (model kém dần theo thời gian).
Use case thực tế
1. Nhận diện khuôn mặt real-time (camera an ninh)
Model: MobileNet-SSD + FaceNet embedding → 30 FPS trên Raspberry Pi 4. Nhận diện local, chỉ gửi cảnh báo lên cloud khi phát hiện người lạ.
2. Phát hiện đối tượng trên drone
YOLOv8n (nano) chạy trên Jetson Nano. Drone tự động tránh chướng ngại vật, đếm đàn gia súc không cần internet.
3. Trợ lý giọng nói offline (smart speaker)
Keyword spotting (phát hiện “Hey Siri”) chạy local trên chip DSP. Khi phát hiện wake word → gửi câu lệnh lên cloud để xử lý phức tạp.
4. Chẩn đoán y tế đeo tay (wearable)
Apple Watch phát hiện rung tâm nhĩ (AFib) bằng ECG, cảnh báo nguy cơ ngã (fall detection) — tất cả on-device. Dữ liệu sức khỏe không rời thiết bị.
5. AR filter (TikTok, Instagram)
MediaPipe Face Mesh chạy 60 FPS trên smartphone, theo dõi 468 điểm trên khuôn mặt để gắn filter real-time.
6. Kiểm tra chất lượng sản phẩm (nhà máy)
Camera công nghiệp + Intel Movidius VPU phát hiện lỗi sản phẩm trên băng chuyền. 100% offline, < 20ms/sản phẩm.
Thách thức & giải pháp
| Thách thức | Giải pháp |
|---|---|
| RAM hạn chế (< 4GB) | Model compression, streaming inference (xử lý từng phần) |
| CPU yếu | Dùng GPU/NPU accelerator, quantization INT8/INT4 |
| Pin hao nhanh | Tắt model khi không dùng, dùng wake word, hardware accelerator (tiết kiệm hơn CPU) |
| Model kém dần (drift) | A/B test model mới, re-train định kỳ, thu thập edge case |
| Cập nhật model khó | OTA update qua cloud, versioning, rollback nếu model mới lỗi |
So sánh Edge AI vs Cloud AI vs Hybrid
| Tiêu chí | Edge AI | Cloud AI | Hybrid AI |
|---|---|---|---|
| Latency | < 10ms | 50-500ms | 10-100ms |
| Riêng tư | Cao (local) | Thấp (upload data) | Trung bình |
| Offline | Có | Không | Một phần |
| Tính toán | Hạn chế | Mạnh | Tận dụng cả hai |
| Chi phí | Hardware đắt | Cloud bill cao | Cân bằng |
| Use case | Real-time, riêng tư | Phức tạp, phân tích sâu | Kết hợp ưu điểm |
Hybrid AI là xu hướng hiện tại: Edge lo việc thường xuyên, phải nhanh — nhận diện khuôn mặt, filter AR. Cloud nhảy vào khi cần sức mạnh — phân tích hành vi phức tạp, re-train model. Tesla là ví dụ điển hình: xe tự lái chạy local, chỉ upload video những tình huống khó lên cloud để model học thêm.
Edge AI đang thay đổi AI deployment như thế nào?
Trước đây AI nghĩa là data center khổng lồ, GPU farm, chi phí hàng triệu USD. Chỉ Google, Meta, Amazon mới làm được.
Bây giờ? AI chạy trên smartphone trong túi bạn, camera ở cửa, đồng hồ đeo tay. Dân chủ hóa thật sự. Developer nhỏ cũng triển khai được nhờ framework mở (TFLite, ONNX) và hardware rẻ (Coral USB stick 60 USD, Jetson Nano 100 USD).
Xu hướng 2026:
- Tiny ML: AI trên MCU (< 1MB RAM) — cảm biến IoT, thiết bị y tế siêu nhỏ
- NPU phổ cập: Mọi smartphone, laptop đều có chip AI chuyên dụng (như GPU ngày nay)
- On-device LLM: Chạy GPT-3 size model local (đã có Llama 3.2 1B chạy trên iPhone)
- Federated Learning: Nhiều thiết bị edge cùng train model mà không chia sẻ dữ liệu thô
Edge AI không đến để thay thế cloud. Nó bổ sung. Tương lai sẽ là AI phân tán — xử lý ở đúng layer phù hợp: edge cho real-time, fog cho trung gian, cloud cho phức tạp. Đúng việc, đúng nơi.
Đọc thêm:
- AI Model Compression: Quantization và Pruning — kỹ thuật tối ưu model để chạy trên edge device
- MLOps: Vận hành mô hình Machine Learning trong production — quy trình deploy và monitor model, bao gồm cả edge deployment
- AI Monitoring & Observability: Theo dõi mô hình trong production — cách theo dõi model drift và performance trên thiết bị edge
Câu hỏi thường gặp
Edge AI khác gì với Cloud AI?
Edge AI xử lý ngay trên thiết bị (smartphone, camera, IoT), không cần internet. Cloud AI gửi dữ liệu lên server xử lý. Edge nhanh hơn, riêng tư hơn nhưng hạn chế tài nguyên. Cloud mạnh hơn nhưng chậm và phụ thuộc mạng.
Thiết bị nào có thể chạy Edge AI?
Smartphone (iPhone, Android), camera an ninh thông minh, xe tự lái, drone, thiết bị y tế đeo tay, loa thông minh, robot công nghiệp. Bất kỳ thiết bị nào có chip xử lý (CPU/GPU/NPU) đủ mạnh đều chạy được Edge AI.
Framework nào phổ biến cho Edge AI?
TensorFlow Lite (Google), Core ML (Apple), ONNX Runtime, PyTorch Mobile, MediaPipe. TensorFlow Lite và ONNX Runtime đa nền tảng nhất. Core ML tối ưu cho iOS/macOS.
Edge AI có cần internet không?
Không bắt buộc. Edge AI chạy hoàn toàn offline sau khi triển khai model. Chỉ cần internet lúc cập nhật model mới hoặc khi kết hợp hybrid (Edge xử lý nhanh, Cloud xử lý phức tạp).
Làm sao tối ưu model cho Edge AI?
Quantization (giảm độ chính xác số từ FP32 xuống INT8), pruning (cắt tỉa trọng số không quan trọng), knowledge distillation (model nhỏ học từ model lớn), model compression. Công cụ: TensorFlow Model Optimization, ONNX Runtime, PyTorch Mobile.


