Quantization AI Model: Giảm Kích Thước Mô Hình Đến 75% Mà Vẫn Giữ Độ Chính Xác
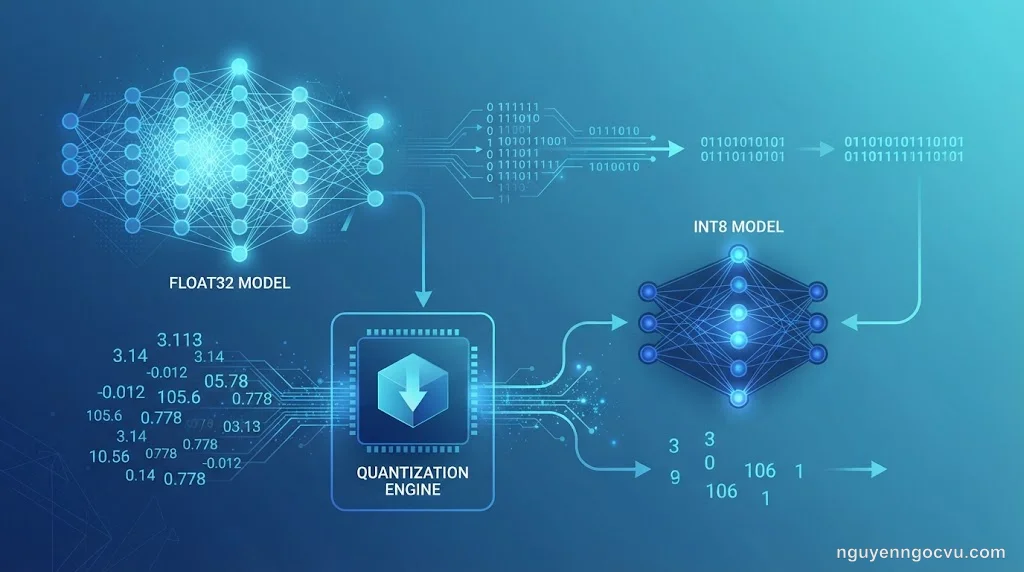
Quantization AI giảm kích thước mô hình từ 50% đến 75% bằng cách chuyển đổi trọng số từ float32 sang int8 hoặc thấp hơn, trong khi vẫn giữ độ chính xác gần như nguyên vẹn. Kỹ thuật này cho phép triển khai các mô hình lớn trên thiết bị edge, smartphone, và IoT với tốc độ inference nhanh hơn 2-4 lần, đồng thời giảm chi phí lưu trữ và băng thông đáng kể.
Quantization AI Model Là Gì Và Tại Sao Quan Trọng?
Quantization là kỹ thuật nén mô hình AI bằng cách giảm độ chính xác biểu diễn số của trọng số và activation từ floating-point (thường là 32-bit) xuống integer với ít bit hơn (8-bit, 4-bit, hoặc thậm chí 2-bit).
Một mô hình GPT-2 kích thước 1.5GB với float32 có thể giảm xuống còn 400MB khi quantize sang int8 - giảm 73% dung lượng.
Lợi ích cụ thể? Inference nhanh hơn 2-4 lần nhờ phép toán integer chạy nhanh hơn float trên hầu hết phần cứng. Băng thông memory giảm → đọc/ghi data nhanh hơn → throughput cao hơn. Smartphone, Raspberry Pi, camera AI giờ đây chạy được model phức tạp mà trước kia chỉ cloud mới đủ sức. Chi phí cloud? Xuống rõ rệt - model nhỏ hơn nghĩa là ít instance, ít RAM, hóa đơn cuối tháng thấp hơn.
Với các mô hình ngày càng lớn (LLaMA, GPT, BERT variants) nhưng nhu cầu triển khai edge lại tăng cao, quantization đã chuyển từ nice-to-have thành must-have.
Các Phương Pháp Quantization Chính
1. Post-Training Quantization (PTQ)
PTQ quantize mô hình sau khi huấn luyện xong, không cần huấn luyện lại. Có 2 loại:
Dynamic Quantization - quantize trọng số trước, quantize activation runtime.
Đây là phương pháp dễ nhất: chỉ 3-5 dòng code, áp dụng ngay cho mô hình đã train sẵn. Đặc biệt hiệu quả với model text/NLP như BERT và GPT. Kết quả? Giảm 50-60% kích thước, tăng tốc 1.5-2x.
# PyTorch dynamic quantization
import torch
quantized_model = torch.quantization.quantize_dynamic(
    model, {torch.nn.Linear}, dtype=torch.qint8
)
Static Quantization - quantize cả trọng số và activation trước inference.
Phức tạp hơn một chút vì cần dataset calibration nhỏ (~100-1000 samples), nhưng đánh đổi xứng đáng: nhanh hơn dynamic quantization gấp 2-3 lần. Đặc biệt mạnh với vision models như ResNet và MobileNet. Accuracy? Gần như không đổi - thường chỉ drop dưới 1%.
2. Quantization-Aware Training (QAT)
QAT mô phỏng quantization trong quá trình huấn luyện, cho phép model “học” cách thích nghi với việc bị quantize.
Ưu điểm:
- Accuracy cao nhất, đặc biệt với quantization mức thấp (int4, int2)
- Cho phép aggressive quantization mà vẫn giữ performance
- Phù hợp với model rất nhạy cảm (medical, autonomous driving)
Nhược điểm:
- Cần GPU + thời gian để fine-tune (thường 5-10% epochs gốc)
- Phức tạp hơn PTQ
- Cần dataset huấn luyện
# TensorFlow QAT
import tensorflow_model_optimization as tfmot

quantize_model = tfmot.quantization.keras.quantize_model
q_aware_model = quantize_model(model)

# Train thêm 5-10 epochs với learning rate thấp
q_aware_model.compile(...)
q_aware_model.fit(train_data, epochs=5, validation_data=val_data)
3. Mixed Precision Quantization
Không phải tất cả layer đều cần quantize giống nhau. Các layer đầu/cuối (sensitive) giữ float16, layer giữa (robust) xuống int8.
Chiến lược:
- Input/output layers: float16 (giữ accuracy)
- Convolutional layers: int8 (tốc độ)
- Attention heads: float16/int8 mix (cân bằng)
Công cụ như TensorFlow Lite và ONNX Runtime tự động tìm config tối ưu qua AutoML.
So Sánh Các Mức Quantization
| Mức | Kích thước | Tốc độ | Accuracy Drop | Khi nào dùng |
|---|---|---|---|---|
| float32 | 100% (baseline) | 1x | 0% | Huấn luyện, benchmark |
| float16 | 50% | 1.5-2x | <0.1% | Cloud inference, GPU đời mới |
| int8 | 25% | 2-4x | 0.5-2% | Edge, mobile, production chính |
| int4 | 12.5% | 3-5x | 2-5% | Extreme edge, IoT, cần QAT |
| int2/binary | 6.25% | 4-6x | 5-10% | Research, đặc thù riêng |
Chọn đúng mức cho đúng ngữ cảnh:
Cloud API với GPU? Float16 là điểm ngọt - cân bằng tốc độ và accuracy. Mobile app thì int8 PTQ thắng áp đảo: accuracy OK, speed tốt, triển khai dễ. IoT device nhỏ buộc phải int4 QAT để compress tối đa.
Riêng với self-driving và medical imaging, đừng chơi trò mạo hiểm - chỉ dùng float16 hoặc int8 QAT khi đã test kỹ, vì đây là những domain mà 1% accuracy có thể quyết định sống chết.
Workflow Thực Hành: Quantize Mô Hình Image Classification
Bước 1: Baseline float32
# Model gốc ResNet50, accuracy 92.5%, size 98MB
model = tf.keras.applications.ResNet50(weights='imagenet')
Bước 2: Thử PTQ dynamic trước (quickest win)
converter = tf.lite.TFLiteConverter.from_keras_model(model)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
quantized_tflite = converter.convert()

# Kết quả: 25MB, accuracy 91.8% (-0.7%), inference 2.3x nhanh hơn
Bước 3: Nếu accuracy chưa đủ → PTQ static với calibration
def representative_dataset():
    for _ in range(100):
        # 100 samples calibration từ train set
        yield [np.random.rand(1, 224, 224, 3).astype(np.float32)]

converter.representative_dataset = representative_dataset
converter.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]
converter.inference_input_type = tf.int8
converter.inference_output_type = tf.int8

static_quantized = converter.convert()

# Kết quả: 25MB, accuracy 92.1% (-0.4%), inference 3.1x nhanh hơn
Bước 4: Nếu vẫn chưa đủ hoặc cần int4 → QAT
q_aware_model = tfmot.quantization.keras.quantize_model(model)
q_aware_model.compile(
    optimizer=tf.keras.optimizers.Adam(learning_rate=1e-5),
    loss='categorical_crossentropy',
    metrics=['accuracy']
)

# Fine-tune 5 epochs
q_aware_model.fit(train_data, epochs=5, validation_data=val_data)

# Convert sang TFLite int8
converter = tf.lite.TFLiteConverter.from_keras_model(q_aware_model)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
qat_quantized = converter.convert()

# Kết quả: 25MB, accuracy 92.4% (-0.1%), inference 3.2x nhanh hơn
Bước 5: Benchmark trên thiết bị thật
# Test trên Android phone qua ADB
adb push qat_quantized.tflite /data/local/tmp/
adb shell "cd /data/local/tmp && benchmark_model --graph=qat_quantized.tflite"

# Output: Average inference time: 28ms (vs 91ms float32)
Công Cụ Và Framework Hỗ Trợ
TensorFlow Lite
- Post-Training Quantization dễ nhất
- Hỗ trợ đầy đủ int8, int16, float16
- Tích hợp Android/iOS SDK
- Converter tự động optimize
PyTorch Mobile
torch.quantizationmodule mạnh- Hỗ trợ dynamic, static, QAT
- Export sang ONNX hoặc TorchScript
- Delegate cho Core ML (iOS) và NNAPI (Android)
ONNX Runtime
- Format trung gian, chạy mọi framework
- Quantization tools tích hợp
- Hỗ trợ mixed precision tự động
- Tối ưu cho CPU inference
Nvidia TensorRT
- Quantization int8 cực nhanh cho GPU
- Calibration tự động
- Fuse layers thông minh
- Dành cho production GPU inference
Các Lỗi Thường Gặp Và Cách Khắc Phục
Accuracy Drop Quá Lớn (>5%)
Nguyên nhân:
- Layer nhạy cảm bị quantize quá mạnh
- Thiếu calibration data
- Distribution mismatch giữa train và calibration
Giải pháp:
- Thử QAT thay vì PTQ
- Tăng calibration samples (500-1000 thay vì 100)
- Dùng mixed precision - giữ một số layer ở float16
- Skip quantize layer đầu/cuối
Inference Không Nhanh Lên
Nguyên nhân:
- Phần cứng không hỗ trợ int8 ops
- Chưa dùng đúng backend/delegate
- Model quá nhỏ (overhead lớn hơn lợi ích)
Giải pháp:
- Kiểm tra hardware support: CPU cần AVX2, ARM cần NEON
- Android: bật NNAPI delegate; iOS: Core ML
- Benchmark trên device thật, không chỉ trên laptop
- Model <10M params: quantization có thể không đáng
OOM Khi Chạy QAT
Nguyên nhân: QAT giữ 2 copies (float + quantized simulation) → VRAM gấp đôi
Giải pháp:
- Giảm batch size xuống 50% so với training gốc
- Gradient accumulation
- Mixed precision training (AMP)
- Chỉ QAT phần cuối model, freeze phần đầu
Quantization Trong Production: Best Practices
Luôn benchmark trên thiết bị đích
Quantized model có thể nhanh 3x trên Android flagship nhưng chậm hơn trên Raspberry Pi 3 thiếu NEON. Bài học đắt: đừng tin số liệu benchmark trên laptop MacBook Pro rồi deploy lên Pi mà không test thật.
Tách calibration set riêng
Đừng dùng validation set để calibrate. Đó là cách mở cửa cho overfitting. Tách riêng ~1% train set ra làm calibration data - đủ representative nhưng không overlap với val.
Monitor accuracy drift - nghiêm túc hơn với quantized models
Quantized model nhạy cảm hơn với data shift so với float32. Set up monitoring metrics riêng, đặt ngưỡng cảnh báo chặt hơn 20-30% so với model gốc.
Version control đầy đủ
Lưu cả config quantization (int8/int4, PTQ/QAT, calibration dataset) trong model card. Lý do? Không phải mọi device đều chạy được int8, và bạn cần biết chính xác model này được quantize thế nào khi debug lỗi 6 tháng sau.
A/B test là bắt buộc, không phải tùy chọn
So sánh quantized vs float trên subset users thật. Đo cả latency lẫn accuracy thực tế - user feedback, task success rate, retention. Có những case quantized model test tốt nhưng user experience tệ vì edge case không xuất hiện trong test set.
Kết hợp kỹ thuật - nhưng đúng thứ tự
Quantization + pruning + knowledge distillation có thể đạt 90% compression với accuracy drop <3%. Nhưng thứ tự sai là tự bắn vào chân: phải train → prune → distill → quantize. Đảo ngược thứ tự = mất accuracy không đáng có.
Tương Lai Của Quantization - Đi Xa Hơn Nữa
Sub-8-bit quantization không còn là research paper xa vời. Llama-2 7B chạy int4 với accuracy tốt nhờ GPTQ và AWQ - đây là proof rằng chúng ta có thể đẩy xa hơn nữa. Int2, thậm chí binary networks, đang dần chuyển từ thí nghiệm thành reality.
Hardware-aware quantization sẽ là game changer tiếp theo: tự động tune config dựa trên chip đích (Apple Neural Engine, Qualcomm Hexagon, Google Edge TPU). Model tự biết mình đang chạy trên chip nào và quantize cho phù hợp.
Dynamic quantization runtime - quantize theo context thay vì cố định: phần đơn giản dùng int4, phần phức tạp lên int8 hoặc float16. Như CPU boost clock khi cần performance cao.
Sự thật đơn giản: với edge AI và on-device LLMs đang bùng nổ, quantization không còn là tính năng thêm mà là điều kiện tiên quyết. Mô hình không quantize được = mô hình không deploy được ở quy mô lớn. Đơn giản vậy.
Đọc thêm:
- AI Model Compression: Nén Mô Hình AI Hiệu Quả Để Triển Khai Thực Tế — tổng quan về các kỹ thuật nén model bao gồm quantization, pruning và knowledge distillation, cùng so sánh khi nào dùng từng phương pháp.
- Edge AI: Triển Khai AI Trên Thiết Bị Đầu Cuối — cách triển khai mô hình AI đã quantize trên smartphone, IoT và thiết bị edge, với case study thực tế về latency và battery life.
- MLOps: Vận Hành Mô Hình Machine Learning Trong Production — quy trình đưa quantized model vào production, bao gồm monitoring, versioning và A/B testing để đảm bảo accuracy không bị drift.
Câu hỏi thường gặp
Quantization khác gì với pruning trong nén mô hình AI?
Quantization giảm độ chính xác số (float32 → int8) để giảm kích thước, còn pruning loại bỏ các trọng số không quan trọng. Quantization giữ nguyên cấu trúc mạng, dễ triển khai hơn, trong khi pruning thay đổi kiến trúc. Hai kỹ thuật có thể kết hợp để đạt tỷ lệ nén tối đa.
Khi nào nên dùng Post-Training Quantization và khi nào dùng Quantization-Aware Training?
Dùng PTQ khi cần nhanh, không có GPU huấn luyện lại, và chấp nhận mất 1-2% accuracy. Dùng QAT khi cần accuracy tối đa (đặc biệt với int4/int2), có tài nguyên huấn luyện lại, và mô hình rất nhạy cảm như object detection hoặc medical imaging.
Quantization có làm giảm tốc độ inference không?
Ngược lại - quantization tăng tốc inference 2-4 lần nhờ phép toán integer nhanh hơn float, bộ nhớ cache hiệu quả hơn, và cho phép batch size lớn hơn. Trên thiết bị edge không có GPU mạnh, quantized model chạy nhanh gấp 3-4 lần so với float32.
Làm sao biết mô hình của tôi có phù hợp với quantization không?
Các mô hình CNN (vision), Transformer nhỏ-vừa (<7B params), và các kiến trúc đã được tiền huấn luyện tốt thường quantize ổn. Thử PTQ int8 trước - nếu accuracy drop <2% là OK. Nếu drop >3%, cần QAT hoặc mixed precision. Mô hình rất nhỏ (<10M params) có thể không đáng để quantize.


